AI crawler và robots.txt: chặn GPTBot, ClaudeBot hay cho phép?
GPTBot, OAI-SearchBot, ClaudeBot, PerplexityBot, Google-Extended làm gì, cái nào ảnh hưởng tìm kiếm AI, và cái bẫy nhóm User-agent khiến robots.txt làm điều bạn không định.
Tác giả: — CTO, ERPFit
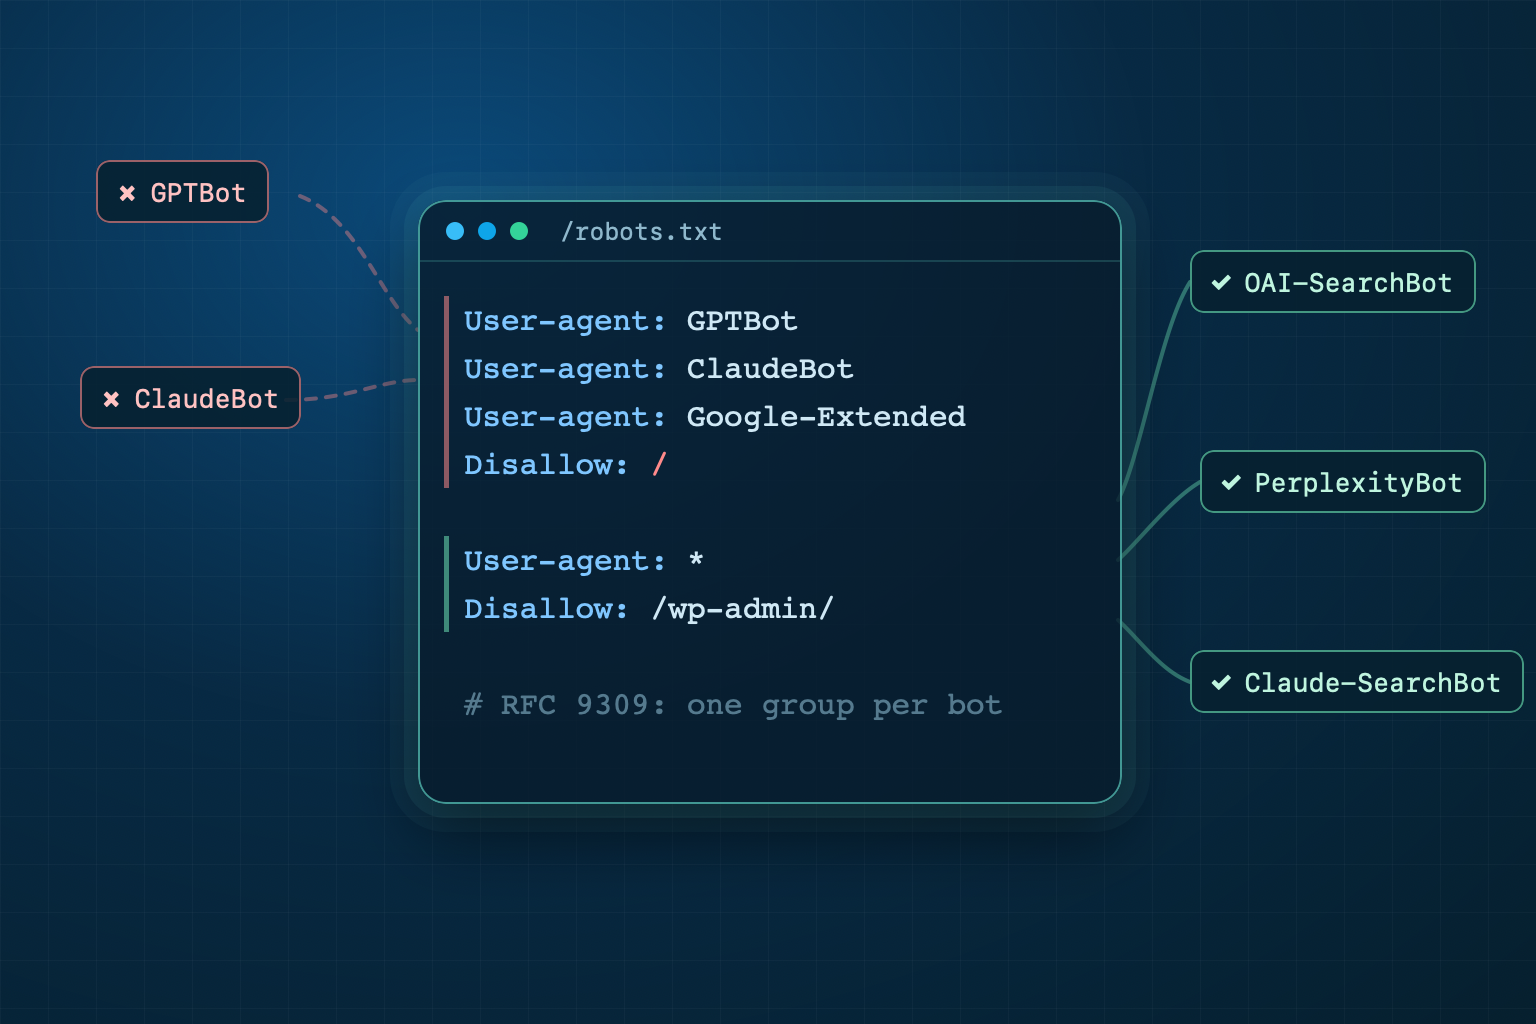
Câu trả lời ngắn: phần lớn website nên cho phép các bot tìm kiếm AI (OAI-SearchBot, Claude-SearchBot, PerplexityBot) và tự quyết định riêng với các bot huấn luyện (GPTBot, ClaudeBot, Google-Extended, CCBot). Hai nhóm này độc lập: chặn huấn luyện không làm bạn biến mất khỏi ChatGPT search hay Google. Rủi ro thật nằm ở chỗ khác: cách robots.txt gom nhóm User-agent khiến nhiều file làm điều chủ website không định.
Điểm chính
- Mỗi nhà cung cấp AI có 2-3 bot với vai trò khác nhau: huấn luyện, chỉ mục tìm kiếm, và truy cập theo yêu cầu người dùng.
- Google-Extended không ảnh hưởng việc có mặt trong Google Search và không phải tín hiệu xếp hạng (Google, 2026).
- Một crawler chỉ tuân theo một nhóm robots.txt: nhóm cụ thể nhất khớp với nó (RFC 9309). Thêm
User-agent: GPTBot+Allow: /là mở cả những thư mục nhóm*đang chặn. - robots.txt là quy ước tự nguyện: bot truy cập theo yêu cầu người dùng của OpenAI và Perplexity có thể không tuân theo.
AI crawler nào đang ghé website của bạn?
AI crawler là bot của các công ty AI đọc trang web để huấn luyện mô hình, xây chỉ mục cho công cụ tìm kiếm AI, hoặc lấy trang khi người dùng hỏi. Bảng dưới tổng hợp từ tài liệu chính thức của từng hãng (tháng 10/2026):
| Hãng | Token trong robots.txt | Vai trò | Tuân theo robots.txt? |
|---|---|---|---|
| OpenAI | GPTBot | Huấn luyện mô hình | Có |
| OpenAI | OAI-SearchBot | Chỉ mục ChatGPT search | Có (áp dụng sau ~24 giờ) |
| OpenAI | ChatGPT-User | Lấy trang khi người dùng yêu cầu | "Có thể không áp dụng" |
| Anthropic | ClaudeBot | Huấn luyện mô hình | Có |
| Anthropic | Claude-SearchBot | Chỉ mục tìm kiếm của Claude | Có |
| Anthropic | Claude-User | Lấy trang khi người dùng hỏi | Có |
| Perplexity | PerplexityBot | Chỉ mục tìm kiếm (không huấn luyện) | Có |
| Perplexity | Perplexity-User | Lấy trang khi người dùng hỏi | "Thường bỏ qua" |
Google-Extended | Token kiểm soát việc dùng cho Gemini (không phải bot riêng) | Có | |
| Apple | Applebot-Extended | Token kiểm soát huấn luyện (không tự crawl) | Có |
| Common Crawl | CCBot | Kho lưu trữ web mở, được nhiều mô hình dùng | Có |
Nguồn: OpenAI, Anthropic, Perplexity, Google, Apple, Common Crawl.
Chặn huấn luyện không đồng nghĩa với chặn tìm kiếm
Đây là hiểu lầm phổ biến nhất. OpenAI ghi rõ: website chặn GPTBot vẫn có thể xuất hiện trong ChatGPT search, vì phần đó do OAI-SearchBot quyết định, và "mỗi cài đặt độc lập". Ngược lại, chặn OAI-SearchBot thì trang sẽ không được hiển thị trong câu trả lời của ChatGPT search, dù vẫn có thể hiện dưới dạng liên kết điều hướng.
Với Google, tài liệu viết: "Google-Extended không ảnh hưởng việc website có trong Google Search và không được dùng làm tín hiệu xếp hạng". Google-Extended chỉ quyết định nội dung có được dùng để huấn luyện Gemini và làm nguồn grounding cho Gemini hay không. Apple tương tự: Applebot-Extended không tự crawl, và trang chặn nó vẫn có trong kết quả tìm kiếm của Apple.
Vì vậy câu hỏi đúng không phải "chặn AI hay không", mà là hai câu riêng: bạn có muốn được trích dẫn trong câu trả lời AI không? (bot tìm kiếm) và bạn có đồng ý cho nội dung vào dữ liệu huấn luyện không? (bot huấn luyện). Với website bán hàng hay dịch vụ, câu trả lời thứ nhất gần như luôn là "có", vì đó là kênh khách hàng tìm thấy bạn. Xem thêm về khả năng được AI trích dẫn.
Cái bẫy nhóm User-agent (RFC 9309)
Theo RFC 9309, mỗi crawler chỉ tuân theo một nhóm: nhóm có dòng User-agent khớp cụ thể nhất với nó. Nhóm * chỉ dùng khi không có nhóm nào khác khớp. Các nhóm không cộng dồn. Xét file này:
User-agent: *
Disallow: /wp-admin/
Disallow: /gio-hang/

User-agent: GPTBot
Allow: /
Nhiều người nghĩ GPTBot "được phép thêm" ngoài các quy tắc chung. Thực tế GPTBot giờ chỉ đọc nhóm của nó, nên /wp-admin/ và /gio-hang/ không còn bị chặn với GPTBot. Muốn giữ, hãy chép các dòng Disallow vào nhóm riêng:
User-agent: GPTBot
Allow: /
Disallow: /wp-admin/
Disallow: /gio-hang/
Ba chi tiết nhỏ khác cũng hay gây nhầm: nhiều dòng User-agent liền nhau dùng chung một nhóm; Disallow: để trống nghĩa là cho phép tất cả; và Disallow: /admin chỉ chặn đường dẫn bắt đầu bằng /admin, không chặn cả website.
Bản thân CiteStat từng mắc đúng lỗi đọc này. Trước ngày 19/10/2026, phần kiểm tra AI crawler của chúng tôi dò robots.txt bằng biểu thức chính quy, nên một dòng Disallow: /wp-admin/ nằm sau User-agent: GPTBot ở bất kỳ đâu trong file bị tính là "GPTBot bị chặn", còn quy tắc trong bộ chấm điểm thì không bao giờ báo lỗi. Hiện cả hai đọc file theo đúng quy tắc nhóm của RFC 9309, cùng một bộ phân tích robots.txt mà crawler của chúng tôi dùng.
Ba mẫu robots.txt theo lựa chọn của bạn
1. Được trích dẫn trong tìm kiếm AI, không cho huấn luyện
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: CCBot
Disallow: /

User-agent: *
Disallow: /wp-admin/
OAI-SearchBot, Claude-SearchBot, PerplexityBot và Googlebot không có nhóm riêng nên dùng nhóm *: được đọc mọi trang trừ /wp-admin/.
2. Cho phép tất cả (phổ biến nhất)
User-agent: *
Disallow: /wp-admin/

Sitemap: https://example.com/sitemap.xml
Không cần liệt kê từng AI bot. Một số công cụ khuyên ghi tên từng bot với Allow: / để thể hiện ý định; nếu làm vậy, nhớ chép các Disallow sang như ở phần trên.
3. Chặn hoàn toàn một bot
User-agent: Bytespider
Disallow: /
Nếu bot không tuân theo robots.txt, bạn cần chặn ở tầng máy chủ hoặc CDN. Anthropic lưu ý chặn theo IP có thể khiến bot không đọc được robots.txt của bạn, nên ưu tiên robots.txt trước.
Kiểm tra robots.txt của bạn bằng CiteStat
Khi bạn quét một URL, CiteStat tải robots.txt và đọc theo quy tắc nhóm của RFC 9309 cho 10 token AI: GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, anthropic-ai, PerplexityBot, CCBot, Bytespider, Google-Extended và cohere-ai. Thẻ GEO / AI Visibility liệt kê từng bot bị chặn khỏi trang gốc. Bộ quy tắc còn kiểm tra file có ghi tên AI crawler rõ ràng không, cùng llms.txt và Agent Readiness.
Gói miễn phí có 10 lượt quét mỗi ngày. Nếu bạn quản lý nhiều website hoặc cần báo cáo AI render đầy đủ, xem bảng giá: gói Pro 500.000₫/tháng (chưa gồm VAT) cho 100 lượt mỗi ngày.