AI crawler có chạy JavaScript không? 7 ngày log máy chủ
7 ngày log: GPTBot tải 157 trang nhưng chỉ tải script 1 lần; Meta-ExternalAgent, Amazonbot không lần nào; Googlebot có. Số liệu, phương pháp, giới hạn.
Tác giả: — CTO, ERPFit
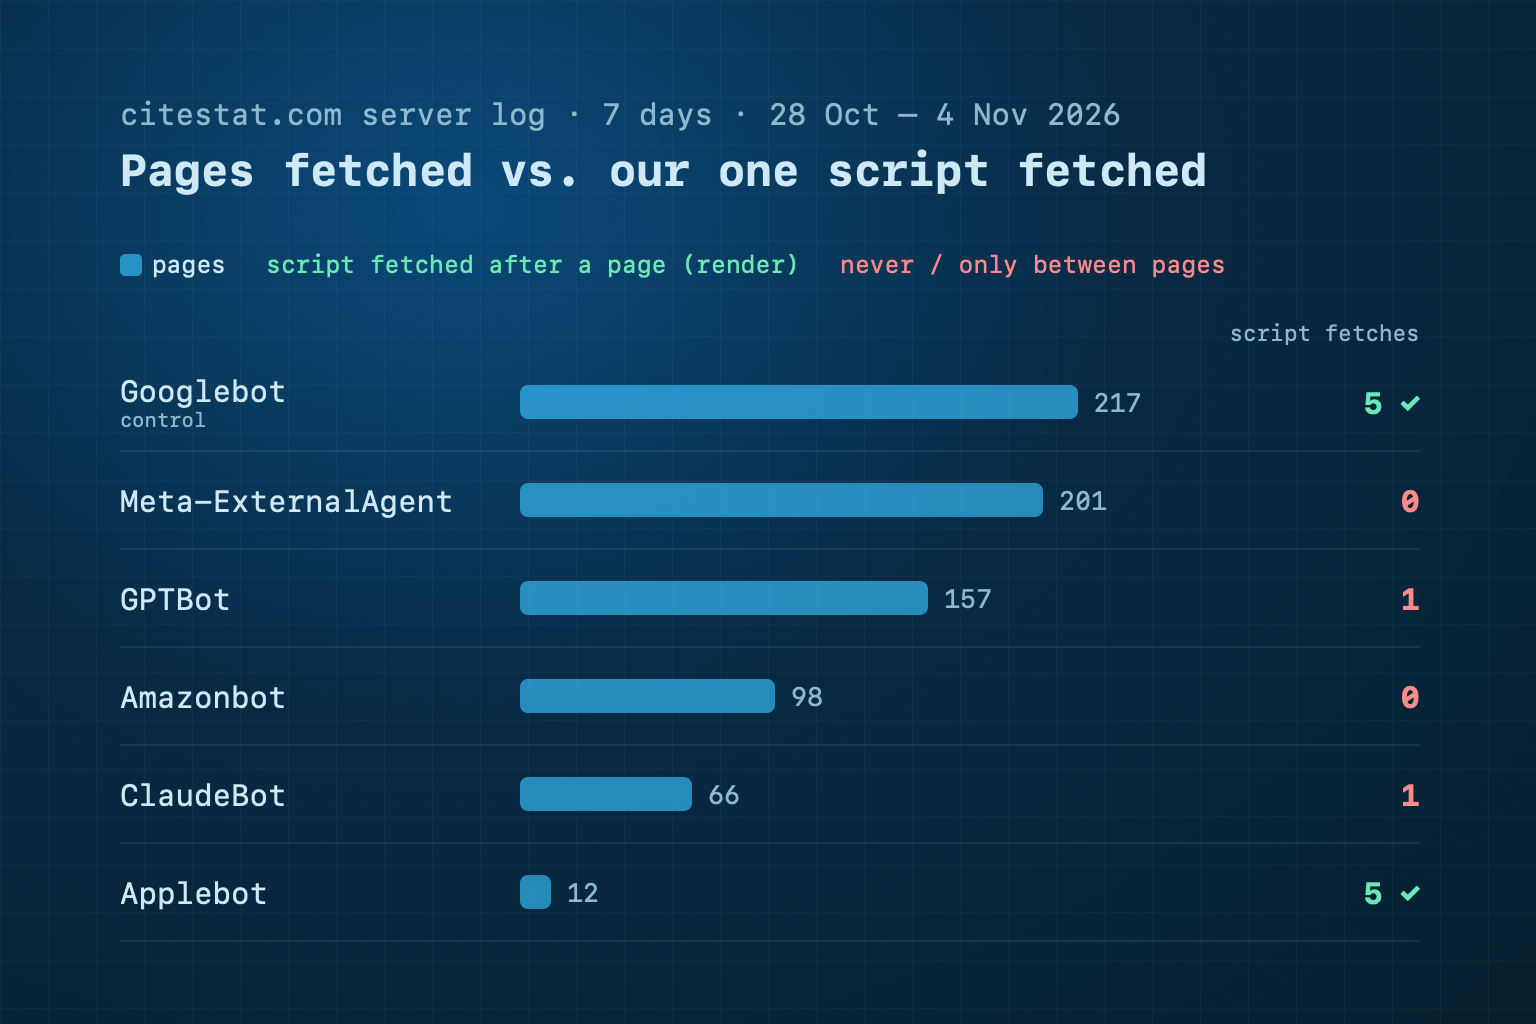
Câu trả lời ngắn: phần lớn là không. Trong 7 ngày log máy chủ của citestat.com (28/10 – 4/11/2026), GPTBot tải 157 trang nhưng chỉ tải file script của trang 1 lần; ClaudeBot tải 66 trang và script 1 lần; Meta-ExternalAgent (201 trang) và Amazonbot (98 trang) không tải lần nào. Googlebot, nhóm đối chứng, quay lại lấy script 5 lần, 4 lần trong số đó chỉ 4–6 giây sau một trang.
Kết quả khớp với số liệu Vercel và MERJ đo năm 2024: crawler của ChatGPT và Claude có thể tải script, nhưng không kết xuất trang. Nội dung bạn muốn được trích dẫn phải có ngay trong HTML đầu tiên.
Điểm chính
- Mỗi trang citestat.com tải đúng một script bên ngoài. Client nào kết xuất (render) trang thì phải tải file đó (trừ khi đã có bản lưu đệm); client chỉ đọc HTML thì không bao giờ hỏi đến nó.
- 7 ngày, khoảng 1.200 lượt truy cập của crawler có khai báo token (trang, robots.txt, sitemap, llms.txt và file .md, ảnh và script): GPTBot 157 trang / 1 script, ClaudeBot 66 / 1, Meta-ExternalAgent 201 / 0, Amazonbot 98 / 0.
- Googlebot (217 trang / 5 script) tải script 4–6 giây sau một trang ở 4 trong 5 lần: dấu hiệu của bước kết xuất. Applebot (12 / 5) cũng tải script, nhưng hàng phút đến hàng giờ sau trang: log không phân biệt được đó là kết xuất hay chỉ là tải.
- Lần tải duy nhất của GPTBot nằm giữa một chuỗi trang, khoảng một URL mỗi giây, như cách nó tải ảnh: một URL tìm thấy trong HTML, không phải bước kết xuất.
Chúng tôi đo như thế nào?
Mỗi trang trên citestat.com tải đúng một file script bên ngoài: /vendor/tailwindcss-3.4.17.js, thư viện tạo kiểu cho trang. Một client kết xuất trang, tức chạy trang trong một trình duyệt, phải tải file này, trừ khi đã có bản lưu đệm. Một client chỉ đọc HTML thì không cần đến nó. Vậy chỉ cần đếm, với mỗi crawler, số trang nó tải và số lần nó tải script.
Từ 02:26 UTC ngày 28/10/2026, máy chủ web của chúng tôi ghi một dòng cho mỗi request có user agent chứa token của một crawler đã biết: thời điểm, đường dẫn, mã trạng thái, token, và loại header Accept. Không lưu IP, không lưu chuỗi user agent đầy đủ.
Các request thử nghiệm của chính chúng tôi được loại khỏi số đếm. Cửa sổ trong bài là đúng 7 ngày, đến 02:26 UTC ngày 4/11/2026.
Mỗi crawler đã tải gì?
Bốn AI crawler tải 522 trang và chỉ tải script 2 lần; Googlebot và Applebot tải script 10 lần.
| Token khai báo | Trang | Lần tải script | Ảnh | Kết xuất trang? |
|---|---|---|---|---|
| Googlebot (đối chứng) | 217 | 5 | 0 | Có: 4/5 lần script đến 4–6 giây sau trang |
| Applebot | 12 | 5 | 20 | Có thể: script đến hàng phút–hàng giờ sau trang |
| Meta-ExternalAgent | 201 | 0 | 1 | Không thấy dấu hiệu |
| GPTBot | 157 | 1 | 12 | Không thấy dấu hiệu |
| Amazonbot | 98 | 0 | 21 | Không thấy dấu hiệu |
| ClaudeBot | 66 | 1 | 17 | Không thấy dấu hiệu |
| OAI-SearchBot, PerplexityBot, Claude-User | 5, 3, 1 | 0 | 1, 3, 0 | Quá ít để kết luận |
Nguồn: log máy chủ citestat.com, 28/10 02:26 – 4/11/2026 02:26 UTC, theo token user agent tự khai báo. bingbot chỉ đọc robots.txt (9 lần) và không tải trang nào trong cửa sổ này, nên không dùng làm đối chứng được.
Trích log gốc (thời điểm UTC, đường dẫn, token; log không lưu IP):
2026-10-30T11:53:54Z GET /docs/api                      agent=GPTBot
2026-10-30T11:53:55Z GET /vendor/tailwindcss-3.4.17.js  agent=GPTBot
2026-10-30T11:53:56Z GET /wiki/google-fonts             agent=GPTBot
2026-10-30T11:53:56Z GET /favicon.svg                   agent=GPTBot
2026-10-30T11:53:57Z GET /dashboard/settings            agent=GPTBot
2026-11-01T09:14:35Z GET /en/wiki/citability            agent=Googlebot
2026-11-01T09:14:39Z GET /vendor/tailwindcss-3.4.17.js  agent=Googlebot
2026-11-02T22:36:54Z GET /en/wiki/indexnow              agent=Googlebot
2026-11-02T22:36:59Z GET /vendor/tailwindcss-3.4.17.js  agent=Googlebot
2026-10-28T10:45:05Z GET /robots.txt                    agent=ClaudeBot
2026-10-28T10:45:44Z GET /vendor/tailwindcss-3.4.17.js  agent=ClaudeBot
2026-11-03T16:47:13Z GET /en/wiki/mcp-server-card       agent=Applebot
2026-11-03T16:59:55Z GET /vendor/tailwindcss-3.4.17.js  agent=Applebot
Meta-ExternalAgent và Amazonbot tải 299 trang mà không hỏi đến script lần nào. Một client chưa bao giờ tải script của trang thì không thể đã chạy nó trên trang của chúng tôi, trừ khi nó mang theo một bản sao lấy từ nơi khác, điều mà log không thấy được.
Googlebot làm đối chứng: dấu vết render JavaScript trong log
Google có kết xuất JavaScript, nên Googlebot là phép thử cho chính phương pháp này. Nếu Googlebot cũng không bao giờ tải script, cách đo bị hỏng. Nó có tải, 5 lần, và 4 lần theo cùng một mẫu. Ví dụ ngày 1/11, Googlebot tải /en/wiki/citability lúc 09:14:35 UTC, rồi script lúc 09:14:39. Ngày 2/11 là /en/wiki/indexnow lúc 22:36:54, script lúc 22:36:59. Trang trước, script vài giây sau: đó là bước kết xuất theo sau bước thu thập. Trong 4 lần đó khoảng cách là 4–6 giây và không có URL nào khác của Googlebot xen giữa; lần thứ năm (31/10) đến 18 phút sau trang gần nhất. Lần tải của GPTBot bên dưới cách trang 1 giây nhưng nằm giữa một chuỗi URL khác.
Quy tắc đọc log: bước kết xuất tải script vài giây sau một trang, không có URL nào khác xen giữa; một crawler chỉ thu thập URL tải script giữa một chuỗi URL khác, cùng nhịp.
5 trên 217 không phải là tỷ lệ kết xuất. Tài liệu JavaScript SEO của Google viết (bản dịch của chúng tôi) rằng Googlebot "lưu đệm rất triệt để nhằm giảm số request mạng" và bộ kết xuất "có thể bỏ qua header cache". Script của chúng tôi lại được gửi với Cache-Control: immutable, thời hạn một năm.
Vì vậy bài này chỉ đưa số lần và thời điểm, không nói phần trăm. Applebot cũng tải script, 5 lần cho 12 trang, nhưng hàng phút đến hàng giờ sau một trang chứ không phải vài giây. Log của chúng tôi vì vậy không chứng minh được Applebot kết xuất; điều đó dựa vào kết luận của Vercel rằng AppleBot kết xuất JavaScript.
Vì sao GPTBot và ClaudeBot vẫn tải script một lần?
Với GPTBot, lần tải chỉ là thêm một URL trong lượt thu thập, không phải bước kết xuất. Ngày 30/10, GPTBot đi qua trang của chúng tôi với nhịp khoảng một URL mỗi giây:
- 11:53:54
/docs/api - 11:53:55 script
- 11:53:56
/wiki/google-fontsvà/favicon.svg - 11:53:57
/dashboard/settings
Script đến 1 giây sau /docs/api, nhưng cùng nhịp với trang và favicon kế tiếp: chỉ là một URL nữa trong danh sách, giống 12 ảnh nó cũng tải (9 ảnh bìa blog, favicon và hai mã VietQR trên trang bảng giá).
ClaudeBot tải script ngày 28/10, 39 giây sau robots.txt và không sau trang nào, rồi tải ảnh bìa blog trong vài phút tiếp theo: khớp với cùng cách giải thích.
Tải một file không có nghĩa là chạy nó. Nghiên cứu của Vercel và MERJ (12/2024) thấy điều tương tự ở quy mô lớn: crawler của ChatGPT và Claude "có tải file JavaScript (ChatGPT: 11,50%, Claude: 23,84% số lượt), nhưng không thực thi chúng" (bản dịch).
Một lần tải trong 7 ngày, xen giữa các trang, khớp với một crawler thu thập URL từ HTML, không phải một trình duyệt. Log của chúng tôi một mình không loại trừ được khả năng một bộ kết xuất có lưu đệm; điều khiến khả năng đó khó xảy ra là thời điểm tải, cộng với nghiên cứu của Vercel và thử nghiệm năm 2026 về việc 12 trợ lý AI lấy trang trực tiếp.
Giới hạn của phép đo này
- Token là tự khai báo. Bất kỳ ai cũng gửi được user agent "GPTBot". Chúng tôi không xác minh IP.
- Một website, một script, 7 ngày. Khoảng 1.200 lượt truy cập của crawler. Đủ để thấy mẫu, không đủ để đo tỷ lệ cho cả web.
- Tải không phải là chạy. Log thấy ai tải file, không thấy ai thực thi nó.
- Bộ nhớ đệm. Một bộ kết xuất có thể dùng lại bản đã lưu; Googlebot làm đúng như vậy.
- Bot ít truy cập thì chưa đủ dữ liệu để kết luận. PerplexityBot 3 trang, OAI-SearchBot 5, Claude-User 1.
Đưa nội dung vào HTML đầu tiên
Giống kết luận của bài trước về SSR và pre-render: đưa nội dung chính, title, meta description, canonical, H1, JSON-LD và liên kết thật vào ngay HTML đầu tiên, bằng kết xuất phía máy chủ (SSR), tạo trang tĩnh hoặc pre-render. Phần tương tác vẫn có thể chạy phía trình duyệt. Danh sách đầy đủ ở JavaScript SEO. Google-Extended là một token trong robots.txt, không phải crawler riêng, nên không bao giờ hiện thành một lượt tải trong log; tính năng AI của Google dùng các trang mà Googlebot đã thu thập và kết xuất.
AI crawler đọc được những gì có sẵn dưới dạng văn bản. Trong cùng log, Meta-ExternalAgent đọc llms.txt rồi tải 13 liên kết .md trong đó trong vòng hai phút. Không crawler nào gửi Accept: text/markdown; xem Markdown negotiation và markdown cho AI agent. Muốn biết bot nào được phép vào, xem AI crawler và robots.txt và trang wiki AI crawler.
Tự kiểm tra log máy chủ của bạn thế nào?
- Chọn một script mà trang nào cũng tải, ví dụ bundle chính
/assets/app.js. - Đếm trang và script theo từng bot. Với log dạng nginx, dòng đầu đếm số lần tải script, dòng sau đếm số trang (gần đúng):
grep GPTBot access.log | grep -c '/assets/app.js' grep GPTBot access.log | grep -vcE '\.(js|css|png|jpe?g|webp|svg|ico|xml|txt)' - Xem thời điểm. Bộ kết xuất của Google tải script vài giây sau trang; bộ kết xuất khác (Applebot ở đây) có thể chậm hàng phút. Một crawler thu thập URL tải script xen giữa các trang khác, cùng nhịp.
- Xác minh bot. OpenAI công bố dải IP của GPTBot; Google hướng dẫn xác minh Googlebot bằng DNS ngược. Chưa xác minh thì ghi là "tự khai báo".
CiteStat kiểm tra việc này thế nào?
CiteStat tải HTML gốc của trang mà không chạy JavaScript, đúng góc nhìn của các crawler trong bảng trên, rồi đếm số từ kết xuất. Bộ quy tắc cảnh báo khi HTML chỉ là khung ứng dụng (thẻ gốc #root, #app, #__next rỗng) với dưới 50 từ, gợi ý kết xuất phía máy chủ (SSR) khi dưới 100 từ, và kiểm tra liên kết <a href> crawl được, cùng robots.txt cho 10 token AI crawler. CiteStat không đọc log máy chủ của bạn; phần đó làm theo bốn bước ở trên. Quét miễn phí một trang của bạn để xem HTML gốc mà GPTBot nhận được có bao nhiêu chữ.
Gói miễn phí có 10 lượt quét mỗi ngày. Nếu bạn quản lý nhiều website, hoặc cần báo cáo AI render đầy đủ mô phỏng đoạn nào Google AI Overviews và Bing Copilot có thể trích, xem bảng giá: gói Pro 500.000₫/tháng (chưa gồm VAT) cho 100 lượt mỗi ngày.
Câu hỏi thường gặp
AI crawler có chạy được JavaScript không?
Phần lớn là không. Trong 7 ngày log của chúng tôi, GPTBot và ClaudeBot tải 157 và 66 trang nhưng chỉ tải script 1 lần mỗi bot; Meta-ExternalAgent và Amazonbot không tải lần nào. Vercel và MERJ (12/2024) cũng thấy GPTBot, ClaudeBot và PerplexityBot không thực thi JavaScript, còn Googlebot và AppleBot thì có.
GPTBot có tải file JavaScript không?
Đôi khi có: 1 lần trong 7 ngày ở đây, xen giữa các trang như một URL bình thường. Vercel đo được 11,50% lượt truy cập của crawler ChatGPT là file JavaScript, nhưng không thấy chúng được thực thi.
Vì sao Googlebot chỉ tải script 5 lần cho 217 trang?
Nhiều khả năng vì bộ kết xuất của Google lưu đệm tài nguyên và có thể bỏ qua header cache. 4 trong 5 lần tải đến 4–6 giây sau một trang, đúng dấu hiệu của bước kết xuất, nên 5 trên 217 không phải tỷ lệ kết xuất.
Làm sao kiểm tra trong log của tôi xem bot có kết xuất trang không?
Chọn một script trang nào cũng tải, đếm trang và lần tải script theo từng user agent, xem thời điểm, rồi xác minh bot bằng dải IP hoặc DNS ngược.
User agent ghi GPTBot có chắc là GPTBot không?
Không. User agent do client tự khai báo. OpenAI công bố dải IP của GPTBot và Google hướng dẫn xác minh Googlebot bằng DNS ngược; số liệu trong bài này là theo token tự khai báo.